
CosyVoice
阿里开源的语音大模型,支持3秒零样本克隆、多语种及指令情感控制,实现150ms超低延迟流式合成。
 Vane(原 Perplexica)
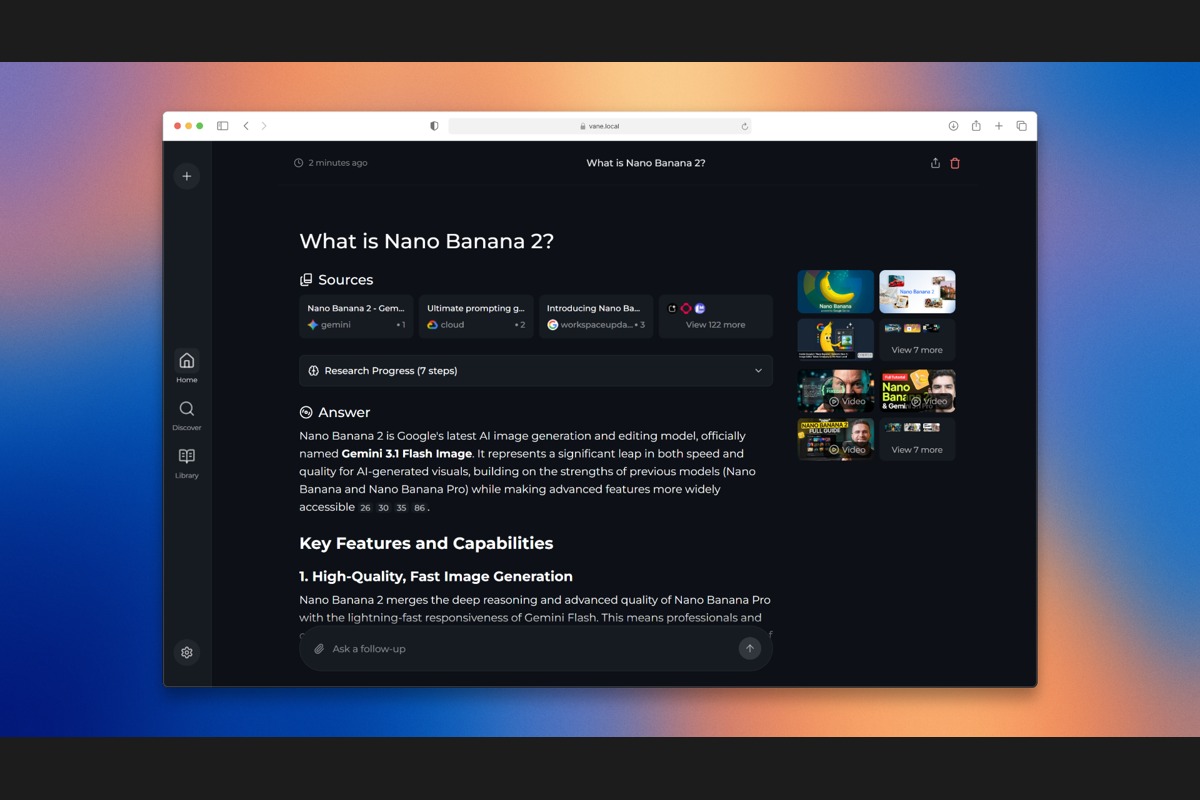
Vane 是原 Perplexica 项目的现用名称,由 Kushagra Srivastava(GitHub 账号 ItzCrazyKns)及社区贡献者维护。旧仓库已经重定向到 Vane,因此两个名字对应同一项目。它把网页搜索、内容读取和大模型回答整合成可自部署的搜索界面,适合希望控制模型选择与部署方式的技术用户。
截至2026年10月26日,官方 GitHub 仓库累计约3.78万 Stars,采用 MIT 许可。高关注度说明社区兴趣,并不代表每次回答都准确,也不意味着它今天刚发布。官方最新 release 为2026年4月10日的 v1.12.2。
Vane 适合开发者搭建自用搜索助手、技术团队验证本地模型问答,以及研究者对多个网页观点进行初步整理。它比纯爬虫或解析库更接近可直接交互的成品,但仍需要部署、配置模型和维护服务。如果只是寻找无需维护的日常搜索工具,托管服务通常更方便。
对研究型工作而言,最有用的不是“替你得出结论”,而是把搜索、阅读和引用聚合到同一流程。重要事实仍应点击来源检查,尤其是日期、数字、政策和存在争议的结论。
| 项目 | 主要定位 | 适合用户 | 需要承担的工作 |
|---|---|---|---|
| Vane | 带引用的AI搜索问答应用 | 希望自部署搜索界面的技术用户 | 模型、搜索服务、访问保护与答案核验 |
| Crawl4AI | 网页采集与清洗组件 | 自建数据管线的开发者 | 采集策略、频率、结构化和来源权限 |
| Docling | 复杂文档解析组件 | 处理PDF/Office资料的团队 | 文档转换、抽样校验和后续检索接入 |
Vane 更接近最终问答界面,另外两者偏向输入数据处理。根据是否需要现成界面、数据类型和维护能力选择,比单看 Stars 更有意义。
MIT 开源不代表运行成本为零:本地模型需要硬件资源,云模型可能按调用收费。自托管也不等于完全离线或绝对隐私,联网搜索会接触搜索引擎与外部网站,选用云模型时相应内容还会发送给模型供应商。敏感资料使用前,应明确完整的数据流与供应商政策。
引用存在不保证回答正确,上游搜索质量、模型能力、上下文长度和网络可达性都会影响结果。官方路线图中标为 coming soon 的 Tavily、Exa 集成不能视为已支持功能。发布说明应与实际安装版本配套查看。
GitHub 仓库与安装文档 · v1.12.2 发布说明 · MIT 许可
界面图与标识:Vane 项目,Copyright © 2026 ItzCrazyKns,MIT 许可。保留官方仓库及许可链接,界面示例中的回答不作为本文事实依据。


 简体中文 简体中文
 English