
Gemma 3n
Google 推出的轻量级开源大语言模型,兼具高性能与易部署,适合本地开发和多场景应用。
 Crawl4AI
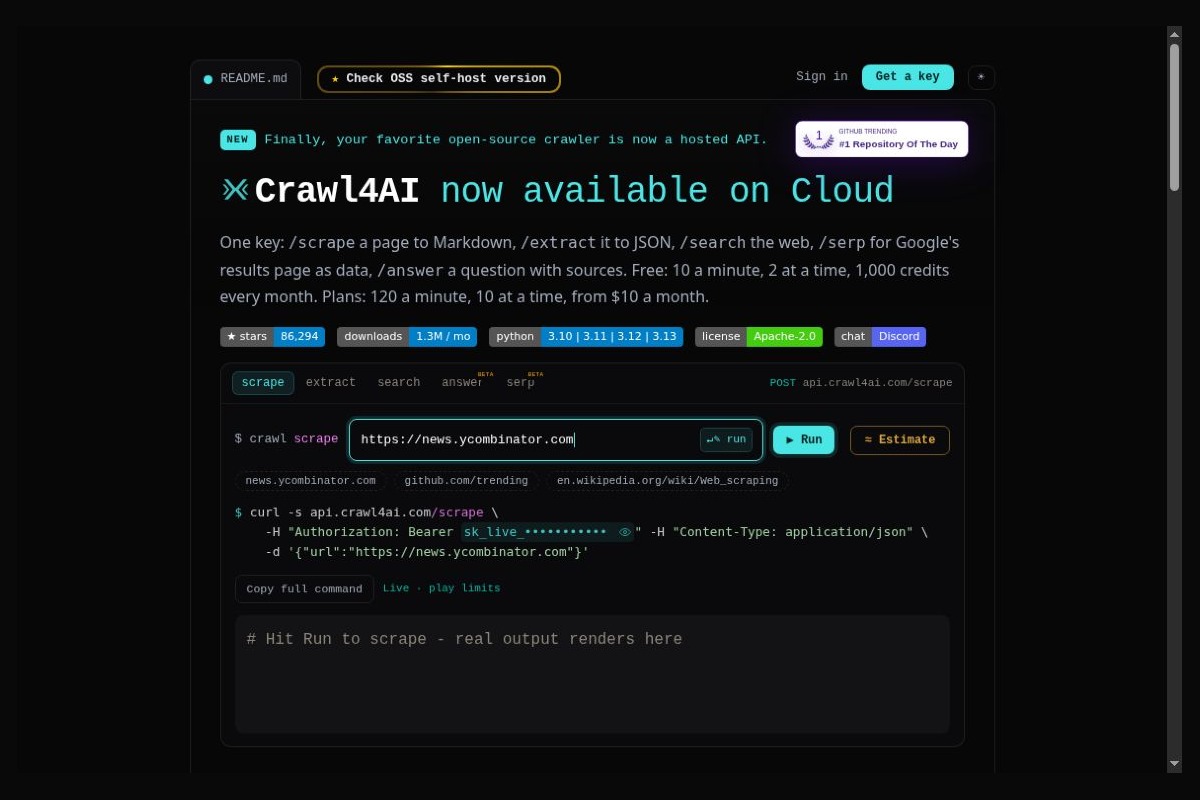
 是 UncleCode 与社区维护的开源网页采集和清洗工具,重点不是再造一个聊天机器人,而是把网页变成大模型能够继续处理的 Markdown 或结构化数据。它适合放在知识库、研究助手和智能体的数据入口:先取得有权限使用的内容,再清理导航、页脚等噪声,保留正文结构和来源链接。
截至2026年10月26日,官方 GitHub 仓库累计约8.63万 Stars。这反映开发者关注度,不等于性能排名或准确率保证。项目代码采用 Apache-2.0 许可;免费自托管库与另外提供的 Crawl4AI Cloud 托管服务需要分开理解。
典型用法包括同步自家技术文档、整理获授权的产品目录、为企业内部知识库收集公开政策资料,以及给研究代理准备可回溯来源的网页片段。它尤其适合具备 Python 和部署基础、希望自己控制采集流程的开发者。若只是偶尔搜索一个问题,现成搜索问答应用通常更省事。
| 项目 | 主要侧重 | 适合的任务 | 重要边界 |
|---|---|---|---|
| Crawl4AI | 在线网页采集、清洗、结构化 | 自建网页知识库和数据管线 | 需要维护浏览器环境并遵守目标站访问规则 |
| Docling | PDF、Office等文档结构解析 | 已有文件的表格、阅读顺序与OCR处理 | 不是通用网页爬虫,复杂文档仍需抽样校验 |
| Vane | 搜索与模型回答整合 | 自托管、带引用的搜索问答界面 | 依赖搜索来源及模型,引用不自动保证正确 |
三者可以互补:Crawl4AI 负责取得网页,Docling 处理复杂文件,Vane 更接近最终的交互式搜索产品,不能只按 Stars 数量决定技术选型。
开源库本身不收许可证费用,但服务器、浏览器资源和第三方模型调用仍有成本。托管云服务的套餐与额度以官网为准,不等同于免费开源库。采集能力也不等于访问授权:应遵守网站条款、robots 规则、版权和合理频率,不应用于绕过登录、验证码或访问限制。处理不可信网址时还需做好网络隔离与权限控制。
2026年10月14日发布的 v0.9.5 包含安全相关修复。部署者应查看官方更新日志并采用适合生产环境的版本,而不是长期停留在旧版本。转换结果仍需验证,尤其是动态加载内容、表格和来源引用。
GitHub 仓库 · 使用文档 · v0.9.5 发布说明 · Apache-2.0 许可
官网截图与标识来源:Crawl4AI 官方网站及项目仓库。




 简体中文 简体中文
 English