
Presentations.AI
AI赋能的PPT制作工具,通过智能生成、设计自动化与团队协作功能,助力用户高效打造专业级PPT,覆盖商务、学术等多场景需求。
当财务说“收入”、销售说“收入”、AI 助手也说“收入”时,三个数字可能来自三套算法。AtScale for AI 关注的正是这种企业查数问题:把指标含义、计算规则和验证过程连起来,让 AI 查询已有业务数据时有据可依。
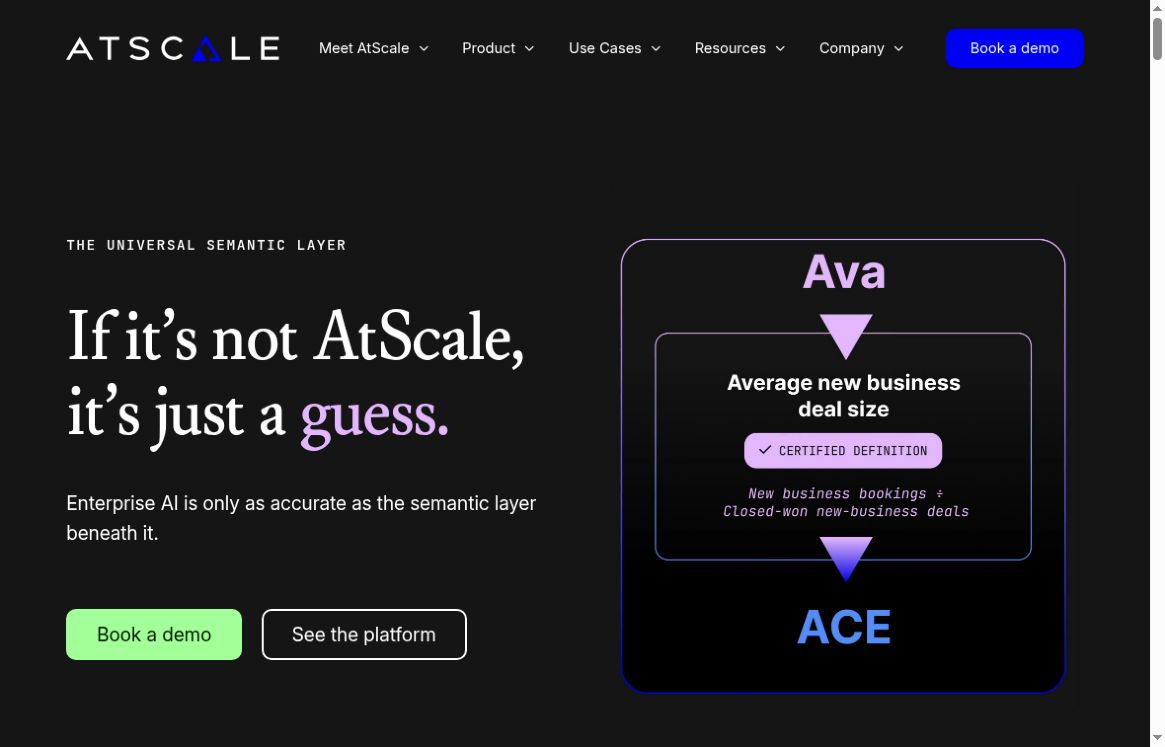
它更适合已经拥有数据仓库、BI 报表和数据团队的企业。评估它时,首先要看自己的指标能否被清楚建模,以及 AI 能否在权限范围内稳定调用这些指标。本文依据截至 2026 年 10 月 17 日的官方资料整理,包含选型分析和建议验证流程;未进行部署或付费实测。
AtScale for AI 是 AtScale 于 2026 年 10 月 15 日发布的企业 AI 能力套件,包含问题澄清、业务指标计算、AI 辅助语义建模和答案评估。需要特别注意交付状态:Ava 与 ACE 已可用,CoModel 与 Canary 仍为即将推出,不能把全部能力理解为已经开放使用。官方发布公告
理解它可以从“语义层”开始。企业数据库保存订单、客户、产品和日期等记录;语义层则把这些记录组织为“净收入”“活跃客户”“同比增长”等业务概念,并明确关联关系和算法。这样,业务人员使用熟悉的词汇提问,数据团队负责维护可复用的解释规则。AtScale 帮助中心:语义层介绍
例如,“本季度华东区销售额”至少还涉及三个问题:按订单创建还是收入确认日期统计?退款是否扣除?客户地区还是门店地区算华东?这类差异很难仅靠更流畅的 AI 回答消除。AtScale 的产品思路,是先把问题对应到确定的业务定义,再执行计算。
AtScale 是企业语义层厂商。公司介绍将产品起点追溯到 2013 年,团队来自 Yahoo 数据团队背景,长期处理跨 BI 工具的指标一致性与大规模数据分析问题。因此,AtScale for AI 是在既有语义层基础上扩展 AI 工作流,而不是从零开始的消费级问答服务。公司介绍
基础平台面向 Snowflake、Databricks、Google BigQuery 等数据平台,也连接 Power BI、Excel、Tableau 等分析工具。AI 通过 AtScale MCP Server 接入,BI 与 AI 可以复用同一套指标定义。具体数据平台版本、部署方式和客户端支持范围仍应逐项核对。官方集成说明
可参阅 Design Center 官方界面说明,了解基础平台的语义建模画布;该页面不代表 CoModel 或 Canary 已正式发布。
Ava 是 Ask、Verify、Answer 的缩写,重点是将自然语言问题对齐到受治理的指标。面对可能指向多种含义的“收入”,它可以在计算前澄清含义,减少选错口径后仍给出漂亮答案的问题。状态:已可用。
ACE 即 AI Computation Engine,负责应用业务定义与计算逻辑,并兼顾查询性能和计算成本。状态:已可用。
CoModel 的定位是把业务上下文转化为指标、维度和关系,辅助维护模型。提议的改动仍需人工审核。状态:即将推出。
Canary 计划使用基于 BIRD-Interact 的评估框架,以及企业自己的问题与已验证答案,定位错误并追踪回归。状态:即将推出。以上四项及状态均以发布公告为准。组件与可用性说明
普通求和比较容易理解,但“库存余额”“毛利率”“截至本月的累计收入”涉及不同计算规则。库存通常可以按仓库相加,却不能把每天库存直接累加为月末库存;比率也往往需要先汇总分子和分母,再重新计算。AtScale 的技术资料将多阶段计算、半可加余额和财务日历列为 ACE 处理的重点,并说明计算被下推到企业已有数据平台。AtScale for AI 技术概览
这对选型的意义是:演示时不要只看“销售额按地区求和”。应把企业最容易出现争议的指标拿出来,验证聚合粒度、时间边界和筛选条件是否始终一致。
以下是结合产品机制的应用分析,并非本文实测结果。
适合收入确认、预算执行、地区利润率等口径严格的问数场景。建议先选一个已能由财务签字确认的指标,以相同口径对照 BI、数据库结果和 AI 回答。涉及正式报表、结算或决策的数字,仍应经过原有审批流程。
适合按门店、地区、品类和时间比较销售、库存及交付情况。要重点检查库存快照、跨期累计、退货处理和层级汇总,避免把“能查出来”误当成“算得正确”。
适合为已有权限体系内的员工提供自然语言问数入口。官方文档列有 Claude、ChatGPT、Databricks 和 Google Gemini 等连接说明,但不同客户端的接入方式与前置条件并不完全相同。AI 应用连接文档
如果同一家公司同时用 Excel、Power BI、Tableau 和 AI 助手,维护一致的业务定义本身就有价值。相反,如果只是个人偶尔分析几个 CSV 文件,采用企业级语义平台的建模、部署和运维成本通常需要特别谨慎评估。
下面是基于官方接入流程整理的落地建议,不是已完成的测试记录。
选一个业务域,例如订单分析。准备 20—50 个问题,并由指标负责人确认答案;题目应覆盖退款、跨月、币种、零值、空值和同义词等边界。这个数量是试点建议,不是官方产品门槛。
同时写清楚每个指标的负责人、定义、数据来源、允许查看的人群和更新时间。没有这些信息,模型生成得再快,也难以判断结果是否符合业务要求。
由数据团队确认部署方案和数据连接,在 Design Center 建立模型,检查维度、度量、关联和时间逻辑。官方画布可查看模型结构,文本编辑器可编辑 SML;模型验证器还会显示结构错误、数据验证提示和警告。Design Center 文档
管理员需要先启用 AtScale MCP Server,再依据对应客户端的文档配置连接。以 Claude 为例,官方要求已启用 MCP、具备相应管理角色,并使用实例的 MCP 地址和指定认证设置。认证密钥应仅由授权管理员在可信配置流程中处理,不能放进聊天记录、公开仓库或文章示例。MCP 管理文档、Claude 接入文档
官方 MCP 工具建议依次发现模型、探索字段、确认字段,再查询结果,最后检查实际发送到仓库的查询。这说明有效验证应覆盖“用的是什么定义”和“最后算了什么”,不能只检查回答文字是否流畅。MCP 工具参考
可用下面的测试问句检查关键环节:
这些是试点问题示例,不代表产品必然以指定格式回应。
将准确率、无法回答时的处理方式、权限隔离、延迟和成本纳入验收。更换大模型、修改指标定义或调整数据表后,重新运行问题集。Canary 尚未发布时,可以先用团队已有测试流程执行这些检查,后续再评估是否采用其自动化评估功能。
以下按各厂商官方文档比较定位,不是性能排名,也不能据此判断某家方案在所有场景更准确。
| 方案 | 官方能力重点 | 选型时应考虑什么 |
|---|---|---|
| AtScale for AI | 在独立语义层基础上连接 AI 问数、计算与计划中的建模和评估能力 | 多 BI 工具、不同数据平台及复杂指标逻辑,是否需要共同复用一套定义;同时核对新组件交付状态 |
| dbt Semantic Layer | 使用 MetricFlow 在 dbt 项目中定义指标、构建语义图并生成查询 | 团队若已有成熟 dbt 工程,可先评估在现有工作流内统一指标的成本,再比较终端连接和所需计算能力 |
| Looker 语义层与 Conversational Analytics | 依托 LookML 业务定义解析自然语言请求,由 Looker 组织查询并解释结果 | 已有大量 LookML 资产的团队,应优先评估复用模型与权限的可行性;不能把 Looker 简化为仅展示图表的工具 |
| Snowflake Cortex Analyst / Cortex Agents 路线 | Cortex Analyst 可利用语义模型或语义视图生成 SQL;当前官方文档建议向 Cortex Agents 迁移 | 数据主要在 Snowflake 时,可比较原生方案和独立语义层的运维、模型复用及跨工具需求,注意迁移方向 |
对比依据:dbt MetricFlow 文档、Looker 对话分析文档、Snowflake Cortex Analyst API 文档。
务实的选择方法是:用同一批真实业务问题、同一组正确答案和相同权限边界做试点,再比较开发工时与总成本。不要仅因为某个产品使用“语义层”或“MCP”等词,就认为它已经覆盖了另一产品的全部能力。
AtScale 当前官方定价以 DSO(已部署语义对象)为基础,按投入生产并可被使用的指标、维度等语义元素计量。定价页列出 Standard、Enterprise 两个版本,表示不按用户席位或查询次数收费;开发中、未向使用者开放的对象不计入相同的生产部署口径。当前页面未给出可直接下单的统一价格,应申请报价并确认合同范围。官方定价说明
采购时建议额外确认:哪些对象计费、重复部署如何计算、超出约定范围如何调整、AI 组件是否全部包含、试用期限与技术支持范围,以及仓库和模型服务费用由谁承担。上述项目是询价清单,不代表官方存在某项特定附加收费。
网上仍能找到 2024 年文章中“每月 2,500 美元起”的历史描述。该数字不能直接当作 2026 年 AtScale for AI 套件的现行报价。历史定价文章
AtScale for AI 值得关注的地方,是让企业 AI 问数建立在可维护、可计算、可检查的业务指标之上。 对已经有数据仓库、跨工具分析需求和指标治理基础的团队,它值得进入试点清单;如果只是处理零散文件,或者希望 AI 在没有规则的情况下自动理解全部业务,应先评估投入与需求是否匹配。
最有价值的下一步,是带着一个有争议的指标、一批已确认答案的问题和明确预算边界,向厂商申请演示与报价,再验证目前已经交付的能力。
资料核对日期:2026 年 10 月 17 日。功能、兼容性和商业条件可能更新,采购及实施以厂商最新文档和合同为准。本文未声称完成安装、接入、性能或准确率实测。


 简体中文 简体中文
 English