
库宝AI工作助手
千库网推出的一站式AI创意服务平台,集AI写作、对话、绘画、图像处理及智能设计等功能于一体,旨在提高用户工作效率并满足多样化创意需求。
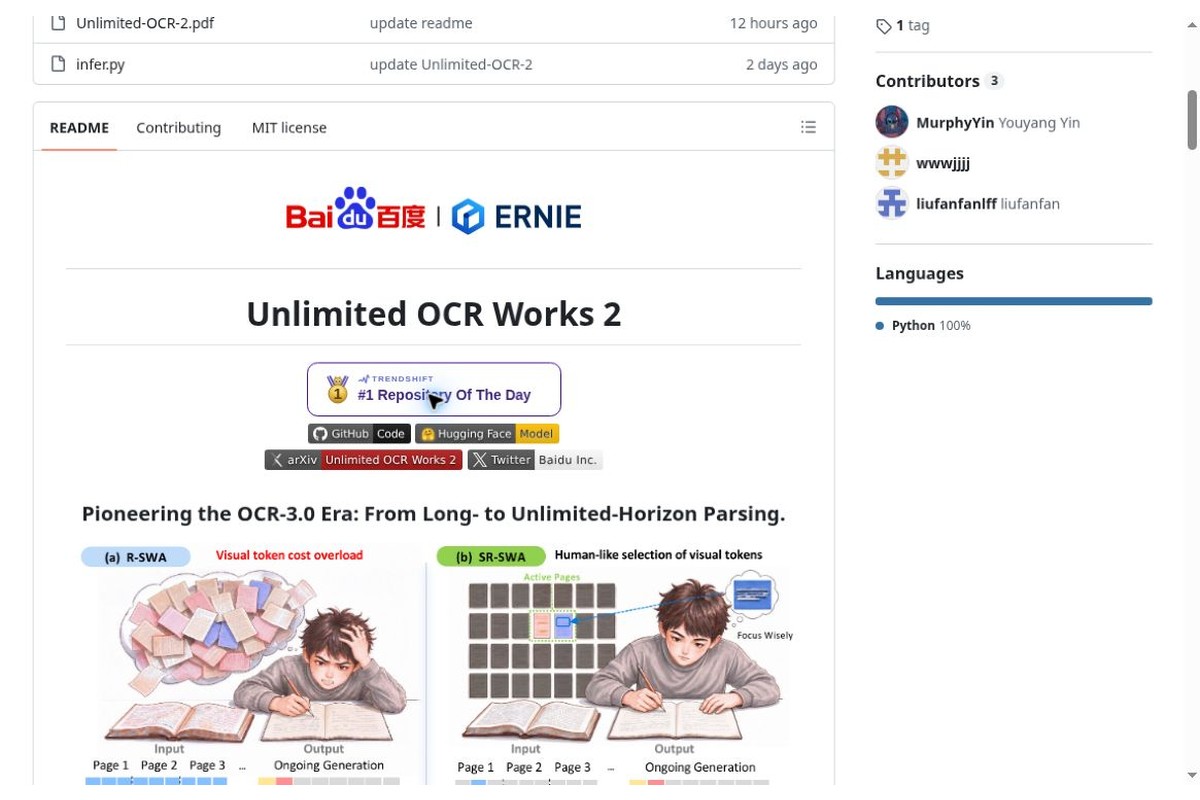
 文心 Unlimited OCR 2
 是百度发布的文档解析模型,重点不只是识别图片中的文字,而是处理多页文档里连续的段落、跨页表格及复杂版面。它适合作为知识库、档案数字化和资料处理流程的前端,把难以检索的页面转换成后续程序可以继续利用的内容。
百度于2026年10月27日发布并开源第二代模型,官方 GitHub 仓库为 baidu/Unlimited-OCR,模型权重入口为 baidu/Unlimited-OCR-2。仓库和模型页标注 MIT 许可。项目首代于2026年6月发布,第二代重点引入 SR-SWA,即稀疏参考滑动窗口注意力,减少超长序列解析中的计算与显存压力。
这里应区分两种使用方式:开源模型供开发者自行部署和集成;百度提供的完整文档解析云服务仍处于公开测试阶段。开源许可不意味着云端服务免费,也不代表自部署没有计算成本。
普通 OCR 往往能找到字符,却不一定知道上一页的表头与下一页的数值属于同一张表。对于财报、技术手册和长篇档案,这种结构丢失会进一步影响检索与问答:系统即使检索到了文字,也可能错配字段或遗漏上下文。
Unlimited OCR 2 的价值在于把跨页关系放进解析环节。但解析结果仍不是业务结论。财务数字、合同条款、表格合并与公式尤其需要与原页对照;后续问答也应保留页码或原文定位,避免让模型输出替代原始证据。
适合有部署能力的开发者、知识库团队、档案信息化团队和需要处理大批多页文件的企业。可以先选三类代表性样本测试:普通扫描件、跨页表格文档和复杂多栏页面,分别统计文字遗漏、阅读顺序、表格结构和耗时,而不只看一两个展示案例。
如果只是偶尔识别几张收据,自建模型可能过重;如果文档敏感且需要可控处理环境,自部署的价值会更明显,但数据隔离、访问控制和日志管理仍需自行建设。
“Unlimited”描述的是处理长文档的技术目标,不是对任意页数、任意硬件和无限并发的保证。仓库示例使用 Python 3.10,并列出在 NVIDIA A800 80GB 环境下测试的依赖;这不是对最低显存的承诺。部署仍应测量峰值显存、超时与输出长度,并检查失败后的重试策略。部分加载方式启用自定义远程代码,使用前应审查可信来源与代码内容。
| 项目 | 侧重点 | 适用场景 | 需要关注 |
|---|---|---|---|
| Unlimited OCR 2 | 多页联合解析与跨页关系 | 超长文档、连续段落、跨页表格 | 模型部署成本与实际样本准确性 |
| Docling | 多格式文档转换和统一文档表示 | PDF、Office 等混合资料进入生成式 AI 流程 | 选择的解析流水线与底层模型 |
| PaddleOCR | OCR 与文档结构化工具体系 | 多语言文字识别、文档解析和工程集成 | 不同模型、模块和部署路线的适配 |
三者不能仅凭一个排行榜判断优劣。真正的选型依据应是你的文档类型、结构保真要求、吞吐量与维护能力。
官方入口:GitHub 项目 · 模型权重 · 百度发布说明 · 云端文档解析 · Docling · PaddleOCR


 简体中文 简体中文
 English