
Laminar
一个开源的AI工程优化平台,专注于从第一原理出发进行AI工程。它帮助用户收集、理解和使用数据,以提高LLM(大型语言模型)应用的质量。
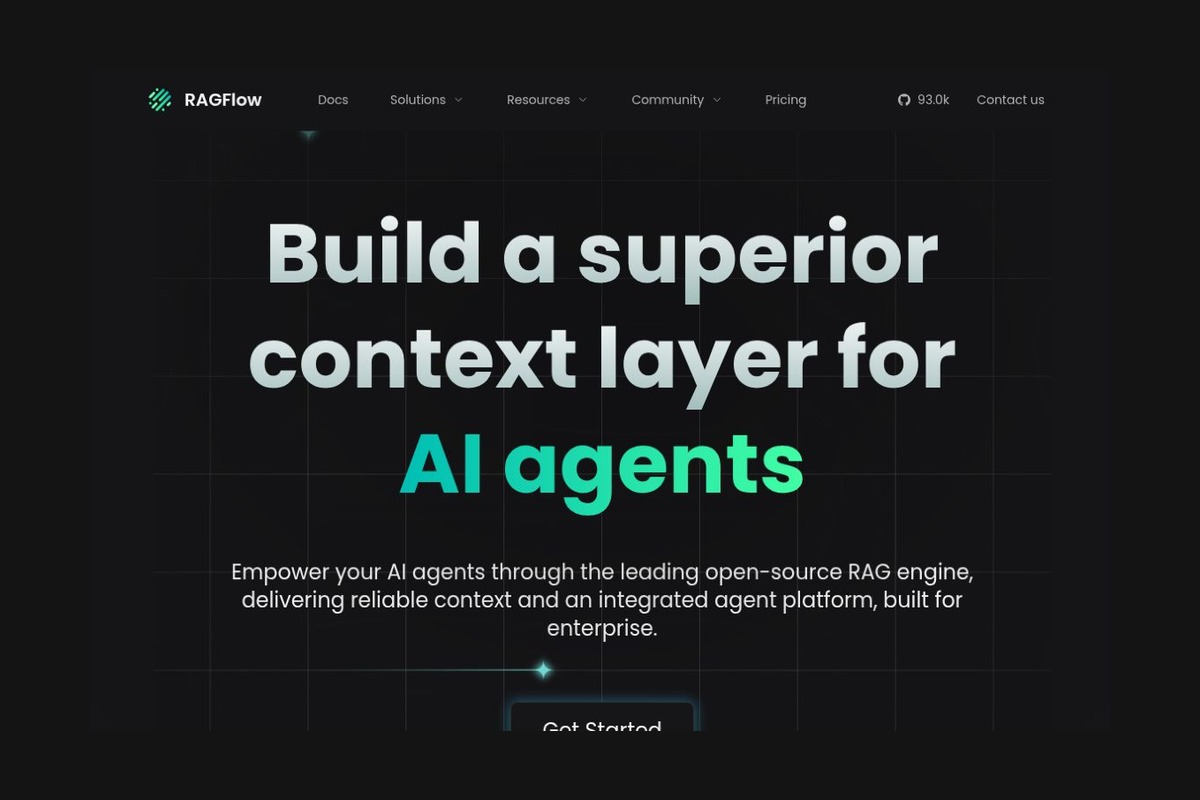
 RAGFlow
 是由 InfiniFlow 维护的开源检索增强生成引擎,核心代码采用 Apache 2.0 许可证。它重点解决的不是“如何做一个聊天框”,而是怎样把格式复杂的文档转换成可检索、可追溯的知识,再把这些知识交给语言模型与智能体使用。
对于企业手册、扫描件、表格、研究资料等内容,回答质量往往受解析、切分和检索影响。RAGFlow 把这些步骤放进相对完整的流程,让使用者能够检查文档处理结果、调整检索策略,并把知识库接入应用或智能体。
它更适合愿意投入数据整理与部署运维的技术团队:例如把设备手册变成维修查询助手,把产品资料变成内部支持知识库,或为研究人员提供可追溯的资料检索。只有少量纯文本、主要需求是个人日常聊天时,轻量桌面工具可能更省事。
2026 年 10 月 16 日的 v1.0.0-rc2 仍带有 RC 候选版标识,采用前应阅读相应版本文档,不能把它写成已经正式稳定的 1.0。开发版文档可能包含超出旧发布包的功能,升级前需要检查数据迁移和兼容性。
开源自托管与 RAGFlow Cloud 是不同使用方式。自托管代码可以按许可证使用,但服务器、存储、模型推理和运维并非零成本;云服务则有各自套餐、额度和条款。若连接外部语言模型或数据源,需另外确认数据流向与访问权限。重要业务结论仍应由人员结合原文判断,不能把有引用的回答视为自动正确。
| 项目 | 主要侧重 | 更适合 | 实施重点 |
|---|---|---|---|
| RAGFlow | 复杂文档、检索和知识处理流程 | 企业知识库、可追溯资料问答 | 数据清洗、解析抽检、检索评估和运维 |
| AnythingLLM | 个人与团队一体化 AI 工作台 | 快速开展资料聊天和轻量任务 | 选择本地或云端组件及工作区管理 |
| LibreChat | 多模型聊天与工具入口 | 统一组织内的 AI 使用体验 | 模型接入、账户权限及工具配置 |
推荐理由:当项目瓶颈不在聊天界面,而在“文档读得对不对、问题能否检索到正确证据”时,RAGFlow 的流程化能力更有价值。建议先证明一类真实资料的检索质量,再扩展数据量和自动化范围。
官方入口:RAGFlow 官网 · GitHub 源码 · 部署文档 · v1.0.0-rc2 发布记录 · 云服务与自托管条款说明




 简体中文 简体中文
 English