
Microsoft IntelliCode
微软开发的智能编码助手,利用AI技术提供个性化的代码补全、建议和优化,旨在提升开发者的编程效率和代码质量。
Expand Fetch 是面向 AI Agent 与开发者的网页读取服务。输入网址后,它把浏览器实际渲染的页面转换为 Markdown,同时返回有用的隐藏 JSON 和可追溯快照,适合为研究助手、知识库和自动化工作流提供网页上下文。
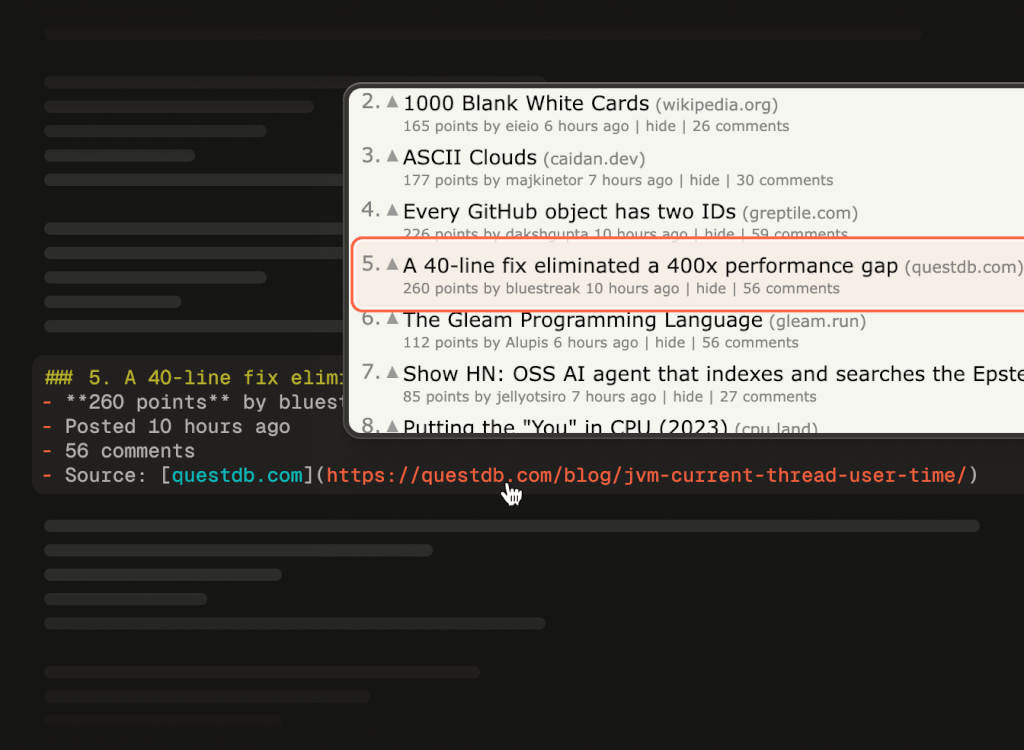
开发研究型 Agent 时,可用它读取产品文档、价格页和功能对比页;搭建知识库时,可将站点内容转为统一输入;需要核对公开网页事实时,可以保留快照与引用,避免网站更新后难以还原原始依据。若只需要人工浏览几个页面,直接打开网站通常更简单。
npx expandai fetch https://example.com,先查看单页 Markdown 输出。Expand 将自身定位为应用研究实验室,创始人为 Tim Suchanek。官方于 2026 年 10 月 14 日发布 Expand Fetch 公告,介绍 Iris、X-Ray、快照与 Highlights 的组合,以及 Crawl、WebSync。公告中的性能比较来自团队自建评测,不宜直接等同于所有网站上的效果。
基础 Fetch 每成功抓取一次消耗 1 credit,1,000 credits 为 1 美元;新组织提供 10,000 免费 credits。Highlights、文档转换、音视频等可能另计用量。CLI 支持受限的匿名预览,常规使用需要登录或配置 API key。Python SDK 在文档中仍标为即将推出。失败、拦截和空结果不收费,但成功抓取到目标网站的错误页可能计费。
Firecrawl、Jina Reader也可列入网页数据工具候选。Expand Fetch 值得重点考察的组合是布局保真、隐藏 JSON 和快照引用。实际选型应使用相同页面比较数据完整度、调用成本与失败处理,而不是只看单一跑分。


 简体中文 简体中文
 English