图解大模型:生成式AI原理与实战
用图解理解词元、嵌入和Transformer,再进入语义搜索、RAG及微调实践。适合有一定Python基础、希望把大模型概念连成体系的读者。
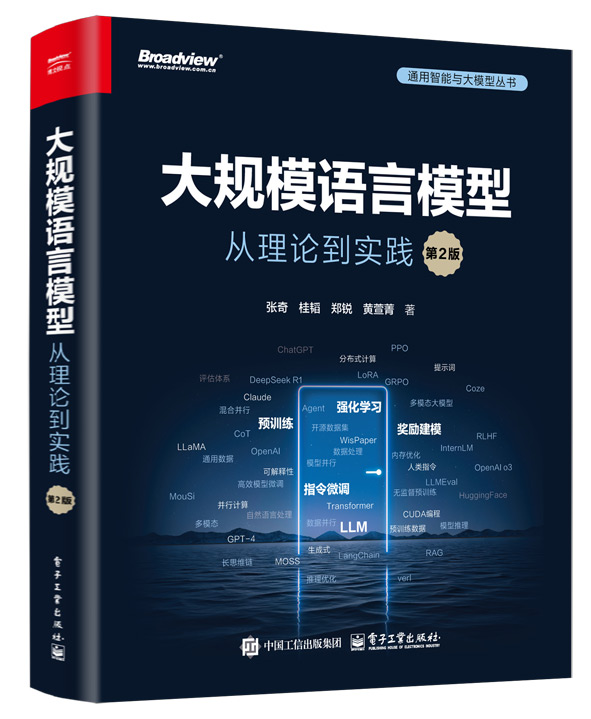
调用一次模型接口很容易,但要解释一个系统为什么有效,往往需要同时理解数据、模型、训练、推理和评估。《大规模语言模型:从理论到实践(第2版)》适合希望把这些环节串起来的中文读者。它的价值不在于提供一个万能方案,而在于帮助你识别问题发生在哪一层,并据此选择下一步实验。
本条目为张奇等编著、电子工业出版社2025年4月出版的第2版,ISBN 9787121500572。选购时请核对“第2版”和ISBN,避免与第一版混淆。出版社书页提供目录及版本信息,具体印次与配套材料以官方说明为准。
官方目录覆盖Transformer、训练数据、分布式训练、指令微调、强化学习、多模态、智能体、检索增强生成、效率优化、评估及应用开发。相关实践涉及DeepSpeed、verl、vLLM、Ollama等工具。第二版目录也纳入了DeepSeek-R1、GRPO等内容。
这些主题可以分成三个阅读层次:理解模型如何获得能力;理解能力怎样被调整和调用;理解系统如何在成本、质量和安全之间作出取舍。这种分层比孤立地背诵技术缩写更有助于做项目决策。
若完全没有编程或机器学习经验,建议先补基础知识,或者先读通识类作品。阅读时不必承诺复现所有训练实验;算力、依赖版本和数据获取条件都会影响实践可行性。
模型路线:先建立架构和数据概念,再关注训练、微调与强化学习,最后回到评估。每个实验都写清楚输入条件、基线和评价指标,避免只比较一次输出的观感。
应用路线:先理解模型能力边界,再结合自己的任务阅读RAG、智能体、推理效率和部署内容。建议选一个小问题,例如对一组公开文档进行问答,逐步加入检索、引用检查和失败样例,而不是一开始搭建复杂系统。
比起收集更多框架名称,更有价值的是一份可以复用的实验记录:为什么选这个模型?数据质量怎样检查?改动提高了哪些指标?增加了多少成本?错误来自知识缺失、检索不足、工具调用失败,还是评价方法本身有问题?能持续回答这些问题,才算把阅读转化为工程能力。
《人工智能的底层逻辑》适合建立全景,本书更适合技术深化;《利用AI进行数据分析》偏向具体工作流程,而本书更关注模型与系统本身。正在做应用的人不必通读后才开始动手,可以以一个小项目贯穿阅读,再按遇到的问题回查相关章节。
大模型工具和开源项目变化很快。代码接口、模型许可、硬件要求和服务条款应以实际使用时的官方文档为准;书籍出版时间不能代表它覆盖之后的全部进展。本条目推荐其系统性和中文技术学习价值,不将其标注为未经核实的今日畅销冠军。
书目信息核对日期:2026年10月17日。阅读路线与比较为本站编辑整理。
封面仅用于识别与介绍本书,版权归相应权利人。


 简体中文 简体中文
 English